


AI-Systemmodellierung mit Methode: Claude & Syside (Teil 1)
Nein, ich bin nicht der Erste, der mit SysML v2 und Claude experimentiert. Dennoch denke ich, dass diese Artikelserie eine wichtige Lücke adressiert: Skalierbarkeit.
Im ersten Teil erstellen wir eine Git-basierte Entwicklungsumgebung, in der die AI nicht einfach „irgendwie SysML erzeugt“, sondern auf einem leichtgewichtigen, für das Beispielprodukt zugeschnittenen Entwicklungsprozess arbeitet. Diesen Prozess leiten wir aus vorhandenen Referenzen wie SYSMOD und der SysML-v2-Spezifikation ab und dokumentieren ihn direkt im Repository.
Anschließend wenden wir den ersten Prozessschritt an: Wir identifizieren Stakeholder und Stakeholder Needs, prüfen sie gemeinsam und modellieren sie in SysML v2. Damit legen wir die Basis für die folgenden Teile, in denen wir schrittweise Systemkontext und Use Cases, Systemanforderungen, Architektur sowie Verifikation und Validierung entwickeln.
Der eigentliche Schwerpunkt liegt dabei weniger auf der Frage, ob Claude SysML v2 schreiben kann. Interessanter ist, wie sich AI so in einen methodisch geführten Entwicklungsprozess einbinden lässt, dass sie auch bei größeren und länger laufenden Vorhaben konsistent, nachvollziehbar und nutzbringend arbeitet.
Das hier vorgestellte Projekt ist unter der MIT Lizenz bei gitHub abrufbar.
Wissen in der AI verankern
Ich hatte kürzlich eine spannende Session mit Matthias Priebe, der mit Claude ein Systemmodell erstellt hatte. Besonders interessant war, dass er explizit SYSMOD als Methode ausgewählt hatte. Als Startpunkt nutzte er das Git-Repository von SYSMOD für SysML v2 von Tim Weilkiens.
Doch hier stellt sich die Frage: Reicht das? Nicht wirklich, dazu sind Entwicklungen einfach zu verschieden. Daher empfehle ich eine Struktur aus drei Schichten:
- Unterste Schicht: Bibliothek. Sammlung relevanter Referenzen zu Methode, Sprache und Werkzeug. Dort gehört zum Beispiel SYSMOD hinein, aber auch die SysML-v2-Spezifikation und bei Bedarf Werkzeugdokumentation.
- Mittlere Schicht: Produktklasseninformation (optional). Um diesen Ansatz zu skalieren, empfiehlt sich eine mittlere Schicht, die eine generische Anpassung für eine Produktklasse enthält.
- Obere Schicht: Produktspezifischer methodischer Leitfaden. Dies ist die Anpassung an das konkrete Produkt, das neu entwickelt oder weiterentwickelt wird.
In diesen Schichten steckt nicht nur Methodenwissen, sondern auch Wissen über Modellierungssprache und Werkzeug. Diese drei Elemente lassen sich bei der Durchführung eines konkreten MBSE-Vorhabens nicht vollständig voneinander trennen.
Schauen wir uns diese Schichten im Detail an.
Bibliothek
Diese Bibliothek sollte zentral verwaltet und von der AI lediglich referenziert werden.
Wenn wir SYSMOD nutzen wollen, können wir nicht nur das Git-Repository verwenden, sondern zum Beispiel auch das SYSMOD-Buch, das Tim freundlicherweise ohne Kopierschutz über Leanpub verkauft. Um solche Inhalte rechtlich sauber im größeren Maßstab zu nutzen, bietet MBSE4U auch Institutional Licensing & Enterprise Access an. Bitte seid fair und bezahlt die Inhalte, die Ihr nutzt.
Viele AI-Systeme können eBooks im EPUB-Format nicht direkt verarbeiten. Ein EPUB ohne Kopierschutz ist jedoch lediglich eine ZIP-Datei, in der der Buchinhalt unter anderem als HTML vorliegt.
SYSMOD für SysML v2 setzt den Einsatz von SysML v2 voraus. Es kann daher sinnvoll sein, zusätzlich explizites Wissen zur Sprache bereitzustellen, auch wenn moderne AI-Systeme bereits viel SysML-Wissen mitbringen.
Natürlich gibt es auch andere Modellierungssprachen. ROOM ist zum Beispiel eine interessante Alternative mit vielen frei verfügbaren Ressourcen. Besonders hervorzuheben ist das ROOM-Buch von Bran Selic et al., das Protos kostenlos und ohne DRM zum Download anbietet.
Auch Werkzeugwissen kann in dieser Bibliothek verankert werden. Da ich mit Syside in textueller Notation arbeiten werde, ist das für mein Beispiel zunächst weniger wichtig. Sobald werkzeugspezifische Funktionen, Validierungen oder Automatisierungen relevant werden, gehört auch die entsprechende Syside-Dokumentation in die Referenzbasis.
In meiner Bibliothek befinden sich nun:
- SYSMOD für SysML v2
- The SysML v2 Book
- OMG SysML v2 Specification: SysML/2.0/Language/PDF
Exkurs: Umgang mit Bibliotheken
Die SYSMOD für SysML v2-Bibliothek sollte auch wie eine richtige Bibliothek eingebunden werden. Der einfachste, aber falsche Weg wäre, die Dateien einfach ins Projekt zu kopieren. Selbst wenn sie nicht eingecheckt werden, ist das nicht empfehlenswert: Die Herkunft und Version der Bibliothek werden unklar, und Updates lassen sich nur schwer nachvollziehen.
Ich sehe zwei sinnvolle Optionen:
- Git Submodule: Das SYSMOD-Repository wird als eigenes Git-Repository in das Projekt eingebunden. Damit ist exakt festgelegt, welcher Commit verwendet wird. Updates erfolgen bewusst auf eine neue Revision. Das funktioniert unabhängig vom verwendeten SysML-v2-Werkzeug.
- Sysand: Sysand ist ein Paketmanager für SysML v2 und KerML, vergleichbar mit Maven, npm oder pip. SYSMOD ist dort als Paket verfügbar und kann mit
sysand add mbse4u/sysmodals Abhängigkeit eingebunden werden. Das ist konzeptionell die sauberere Lösung für wiederverwendbare SysML-v2-Bibliotheken und erleichtert insbesondere Versionsverwaltung und Abhängigkeiten.
Um für dieses Beispiel möglichst werkzeugunabhängig zu bleiben, habe ich mit Git Submodules gearbeitet. Damit hängt das Repository nur von Git und nicht von einem zusätzlichen SysML-v2-Paketmanager ab. Die README.md des Projekts beschreibt, was beim Einrichten der Arbeitsumgebung zu beachten ist.
Anpassung nach Produktklasse (optional)
Um den hier beschriebenen Ansatz zu skalieren, empfiehlt es sich, für die Organisation und die jeweilige Produktklasse spezifische Methoden-, Sprach- und Werkzeuginformation zusammenzustellen. Wenn eine Organisation nur eine relevante Produktklasse hat, reicht entsprechend eine einzige solche Schicht.
Wagner ist zum Beispiel ein Anlagenbauer für Brandschutzsysteme. Hier könnte es sinnvoll sein, zwischen stationären Systemen, etwa einer Lagerhalle, und beweglichen Systemen, etwa einem Zug, zu unterscheiden.
Für mein Beispielprojekt lasse ich diese Ebene aus.
Anpassung für die Produktentwicklung
Dies ist die Information, die die AI direkt nutzen wird und die im Repository als Markdown-Dateien abgelegt wird. Sie kann und sollte die darunterliegenden Referenzschichten verweisen, um Redundanz und Duplizierung zu vermeiden.
Ich vermeide hier bewusst den Begriff „Projekt“, da dieser suggeriert, dass der Lebenszyklus des Produkts keine Rolle spielt.
Diese Beschreibung kann nun konkrete produktspezifische Eigenarten berücksichtigen. Handelt es sich um eine Greenfield-Entwicklung oder um eine Weiterentwicklung? Welche Vorschriften müssen berücksichtigt werden, die in der Produktklasseninformation noch nicht enthalten sind? Welche Modellierungsentscheidungen und Arbeitsweisen sollen für genau dieses Produkt gelten?
Spätestens an dieser Stelle sollten auch Hinweise zum verwendeten Werkzeug und zum CI-Vorgehen eingearbeitet werden, sofern sie für die konkrete Produktentwicklung relevant sind.
Claude Code oder Claude Chat in VS Code?
Dass ein solches Projekt nicht im Webbrowser entwickelt werden sollte, ist wohl klar. Weiterhin fiel im September 2026 die Wahl der AI auf Claude.
Weiterhin war die Wahl der Entwicklungsumgebung eben falls einfach: Es kam nur VS Code, bzw. eines dessen Derivate in Frage. Ich nutze VSCodium, hauptsächlich, damit mir git Copilot nicht dazwischenfunkt, der sich bei VS Code nicht abschalten lässt.
Doch die nächste Frage war, wie genau ich Claude einsetzen würde. Die „offensichtliche“ Wahl wäre Claude Code auf der Konsole. Doch die Claude Extension hat auch ihren Reiz. Hier ein Vergleich der wichtigsten Aspekte:
| Dimension | Claude Code in der Konsole | Claude-Chat in Codium |
|---|---|---|
| Primäre Oberfläche | Terminal | IDE-Chat/Sidebar |
| Arbeitsmodell | AI-Agent arbeitet auf einem Repository | AI-Coding-Assistent direkt im Editor |
| Ausgangskontext | Aktuelles Verzeichnis/Repository | Geöffnetes Projekt + Editor-/IDE-Kontext |
| Dateizugriff | Liest und durchsucht Dateien direkt | Liest Projektdateien über die IDE-Integration |
| Bearbeitung | Bearbeitet und erstellt Dateien direkt | Schlägt Änderungen vor bzw. wendet sie über die IDE an |
| Größere autonome Aufgaben | Sehr gut geeignet | Gut, aber Chat fördert eher kleinere Iterationen |
| Präzise Code-Navigation | Suche, grep, ggf. LSP-ähnliche Werkzeuge je nach Setup | Sehr gut, da die IDE Symbole, Dateien und Diagnosen kennt |
| Code selbst ansehen/bearbeiten | Wechsel zwischen Terminal und Editor | Sehr gut, Code und Claude sind direkt zusammen |
| Interaktive Diskussion über Code | Unterhaltung im Terminal | Komfortabler durch Chat-Oberfläche |
| Kontext aus Cursor/Auswahl | Weniger implizit; Dateien oder Stellen müssen genannt werden | Stark: markierter Code, aktuelle Datei, Fehler usw. |
| Automatisierung/Skripte | Sehr gut | Weniger geeignet |
Nach dieser Tabelle ist der Chat der klare Gewinner, zumindest in der frühen Phase, wo viel interaktiv erarbeitet wird.
Umsetzung
Wir sollten die Vorgehensweise für die Produktentwicklung nicht in einem Schritt vollständig festlegen. Stattdessen würde ich sie schrittweise entwickeln. Die folgende README.md im Verzeichnis method spiegelt dieses Vorgehen wider.
AI-spezifische Anleitungen
Alles bisher gesagte setzt keine bestimmte AI voraus. Zur Zeit (September 2026) ist zwar Claude die offensichtliche Wahl, das kann sich jedoch ändern.
Meine Empfehlung ist es, durch das Anlegen einer AGENTS.md das Projekt AI-neutral zu halten.
Für Claude könnte dann eine sehr kurze CLAUDE.md im Wurzelverzeichnis liegen:
CLAUDE.mdRead and follow `AGENTS.md`.Beispielprodukt: Der intelligente Ventilator
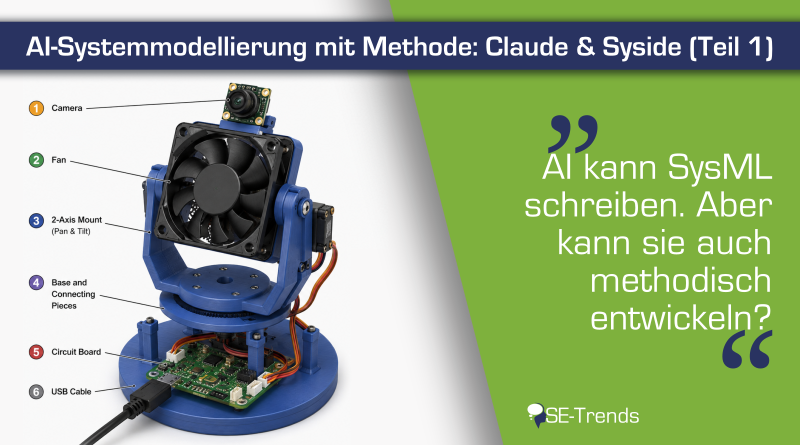
Wer sich an die Hitzewellen in diesem Sommer erinnert, freut sich sicher über das Beispielprojekt, den intelligenten Tischventilator. Ein Mockup ist im Titelbild zu sehen (aber soll die Lösung natürlich nicht vorwegnehmen). Das Gerät soll eine Person am Schreibtisch kühlen und den Luftstrom automatisch an deren Position anpassen.
Das Beispiel ist ein Greenfield-Produkt. Es existiert also keine bestehende Architektur, die berücksichtigt werden muss. Gleichzeitig handelt es sich um einen bewusst kleinen Demonstrator. Themen wie funktionale Sicherheit, Zulassung oder umfangreiche regulatorische Anforderungen spielen zunächst keine große Rolle, können wir aber trotzdem beispielhaft berücksichtigen.
Damit brauchen wir auch keine umfangreiche Entwicklungsmethode. Statt eine Methode vollständig zu übernehmen, möchte ich sie für dieses Produkt zuschneiden. Dabei gilt das KISS-Prinzip: So wenig Prozess und Modellierung wie möglich, aber genug, um die Entwicklung nachvollziehbar und methodisch sauber durchzuführen.
Entwicklungsprozess erstellen
Der erste Schritt besteht daher darin, aus den Referenzen einen einfachen produktspezifischen Entwicklungsprozess abzuleiten. Dieser wird in method/01-development-process.md dokumentiert.
Hier nun der Prompt zur Erzeugung der Methode:
Prompt zur Erzeugung von method/01-development-process.mdCreate `method/01-development-process.md` for this repository.
Context: We are developing a small greenfield demonstration product: an intelligent desktop cooling device.
The product should ultimately provide cooling to a person at a desk and adapt the airflow to the person's position. A possible later implementation could use a fan, sensing, and an automatically adjustable orientation, but the development process must not assume this solution.
This is intentionally a small educational project used to demonstrate AI-assisted systems engineering with SysML v2.
Project characteristics:
- Greenfield development
- Small product and small model
- Educational/demo purpose
- Few relevant regulatory constraints
- SysML v2 is used for system modeling
- SYSMOD is the primary methodological reference
- Syside is used as the modeling environment
- Follow the KISS principle
- Avoid process steps and artifacts that do not add value to this example
- Maintain a clear progression from user needs toward architecture
- Do not prematurely introduce solution decisions
Use the reference material described in `references/README.md`.
Follow the principles defined in `method/README.md`.
Consult the methodological sources before defining the development process.
Do not include detailed guidance for individual engineering activities. Those will be documented in separate files as the project progresses, for example:
- `02-requirements.md`
- `03-system-context.md`
- ...
This document should define only the minimum process needed for this product:
- the main development activities;
- their sequence;
- the expected result of each activity;
- important tailoring decisions.
Do not describe detailed inputs, outputs, completion criteria, or activity guidance unless they are needed to understand the overall process.
Keep the document short. Prefer omission over completeness.
For important methodological choices, reference the source material that supports the choice.
Before writing the file, briefly state the proposed process and the methodological sources used so that the tailoring decision can be reviewed.Für diese Aufgabe habe ich Opus 5 mit „Medium“ verwendet, was zum folgenden Dokument geführt hat:
Das Ergebnis zeigt gut, was mit „Tailoring“ gemeint ist: Claude hat die elf SYSMOD-Aktivitäten auf fünf reduziert. Dabei wurden nicht einfach Schritte gestrichen, sondern zusammengefasst oder bewusst als nicht notwendig eingeordnet. Projekt-Framing wird als bereits gegeben betrachtet, Systemkontext und Use Cases werden kombiniert, eine separate frühe Systemidee entfällt, und die Architektur wird zunächst als eine einzige Aktivität behandelt. Gleichzeitig bleiben die wesentlichen Entwicklungsschritte erhalten: von Stakeholdern und Bedürfnissen über Kontext und Anforderungen zur Architektur und schließlich zu Verifikation und Validierung. Für mich ist das ein gutes Beispiel dafür, wie AI methodisches Wissen auf einen konkreten Entwicklungsgegenstand zuschneiden kann.
Schritt 1: Stakeholders and Needs
Gut, unser zugeschnittener Entwicklungsprozess beginnt mit Stakeholders and Needs. Bevor wir überlegen, welche Stakeholder und Bedürfnisse für unser Beispiel relevant sind, müssen wir festlegen, wie wir diese methodisch und in SysML v2 darstellen wollen.
Dazu legen wir einen weiteren methodischen Leitfaden an. Hier verbinden wir erstmals die Methode mit konkreter SysML-v2-Modellierung. Claude muss dafür sowohl die methodischen Quellen wie SYSMOD und The SysML v2 Book als auch die SysML-v2-Sprachreferenz konsultieren.
Prompt zur Erzeugung von method/02-stakeholders-and-needs.mdCreate `method/02-stakeholders-and-needs.md` for this repository.
Context:
The first activity in `method/01-development-process.md` is "Stakeholders and Needs".
Before identifying the actual stakeholders and needs for this product, define how this activity should be performed and how its results should be represented in SysML v2.
Use:
- `method/README.md`
- `method/01-development-process.md`
- `references/README.md`
Consult the relevant methodological sources, especially SYSMOD and The SysML v2 Book.
Consult the SysML v2 specification where language semantics or notation are involved.
Keep the guidance minimal and specific to this small educational project.
The document should define:
- how relevant stakeholders are identified;
- what qualifies as a stakeholder need;
- how needs should be formulated;
- how solution bias should be avoided;
- how stakeholders and needs are represented in SysML v2;
- any minimal traceability needed at this stage.
Do not identify the actual stakeholders or needs yet.
For important methodological or language choices, reference the supporting source material.
Before writing the file, briefly state the proposed approach and the sources used so that the method can be reviewed.Früh führen, kontinuierlich prüfen
Gerade am Anfang sollte die AI streng geführt werden. Wenn sie bereits bei Stakeholdern oder Needs in die falsche Richtung läuft, baut jeder weitere Schritt darauf auf. Dann entsteht schnell viel sauber formuliertes, aber fachlich unpassendes Material. Das kostet Zeit und Tokens, weil später ganze Ketten von Needs, Anforderungen und Architekturelementen korrigiert werden müssen.
Deshalb arbeite ich mit kurzen Review-Punkten zwischen den inhaltlichen Schritten: erst Stakeholder vorschlagen, prüfen und freigeben; dann Needs ableiten, prüfen und freigeben; erst danach modellieren. Die AI übernimmt weiterhin den Großteil der Arbeit, aber die Richtung wird früh und kontinuierlich kontrolliert.
Fehlerhafte SysML-v2-Syntax ist dagegen meist nur ein kleines Ärgernis, weil sie sich mit Werkzeugunterstützung schnell erkennen und korrigieren lässt.
Hier lohnt es sich nicht, die Prompts im Einzelnen aufzuführen. Aber dies sind die Schritte, die auch zeigen, in welcher Granularität ich hier mit der AI arbeite:
- Stakeholder identifizieren. Claude schlägt auf Basis des Project Frames und von
02-stakeholders-and-needs.mdeine möglichst kleine Menge relevanter Stakeholder vor. Ich prüfe, hinterfrage und bestätige diese. - Needs ableiten. Claude formuliert die Bedürfnisse für die bestätigten Stakeholder. Ich prüfe insbesondere Lösungsneutralität, Vollständigkeit und Notwendigkeit.
- In SysML v2 modellieren. Erst jetzt modelliert Claude die freigegebenen Stakeholder und Needs nach dem Methodenleitfaden. Ich prüfe das Modell und die Syside-Validierung.
- Änderungen übernehmen. Claude zeigt die Änderungen und die wesentlichen Entscheidungen. Ich prüfe den Diff und committe den Stand.
Modellieren: Mit und ohne Syside
Um die Fähigkeiten und Grenzen von Claude zu erkunden, führte ich Schritt 3 mit dem folgenden Prompt aus, allerdings ohne Syside vorher installiert zu haben. Spanned dabei ist der Satz am Ende: „Validate the result with the available Syside tooling if possible.“
Prompt Schritt 3: In SysML v2 modellieren.Model the stakeholders and needs in SysML v2 according to
method/02-stakeholders-and-needs.md.
Create the necessary model files, use the SYSMOD library as specified, and keep the model minimal.
Validate the result with the available Syside tooling if possible.
Then show what was created and report any validation issues.Claude erstellt zwar das Modell, aber schafft es nicht, die Validierung durchzuführen, Da Syside nicht installiert ist. Dabei stellt sich heraus, dass das generierte Modell fehlerhaft ist. Der Fehler war trivial: Bei concern muss das subject an erster Stelle stehen. Doch ohne Syside konnte Claude den Fehler nicht finden.
Die generierten Modelle sind in gitHub zu finden. Dort befindet sich auch ein Script, welches MD-Tabellen aus dem SysML generiert. Auch wenn Syside das Darstellen als Tabelle erlaubt (mit dem kostenpflichtigen Modeler), so wollte ich eine leichtegewichte Lösung zum einfachen Teilen (read-only) haben, über die ich unter anderem hier im Blog Tabellen einfügen kann.
Ergebnis: Stakeholders und Stakeholder Needs
Hier nun die Tabellen der Stakeholder und Stakeholder Needs:
Stakeholders
Priorität folgt der SYSMOD stakeholder priority map.
| Stakeholder | Description | Categories | Risk | Effort | Priority | Needs |
|---|---|---|---|---|---|---|
| Desk Worker | The person working at the desk that the system serves. Experiences the cooling effect directly and is the reason the system exists. Source of the comfort, usability, and privacy needs. | User | Critical | Low | 0.25 | Thermal Relief, Comfort Without Attention, Simple Use And Control, Privacy Of People Nearby, Safe Nearby Use |
| Office Neighbor | A person sharing the workspace who is affected by the system without interacting with it. Receives no benefit from it, so their interests oppose those of the desk worker. Source of the needs that limit the effect of the system on its surroundings. | Other | Medium | Medium | 0.25 | Undisturbed Shared Workspace, Privacy Of People Nearby, Safe Nearby Use |
| Product Manager | The role that decides what the system must do and resolves conflicts between the desk worker and the office neighbor. Source of the needs concerning the intended market. | Requirement Owner | High | Low | 0.19 | Fits Ordinary Workplaces |
Stakeholder Needs
| Need | Description | Priority | Stakeholder |
|---|---|---|---|
| Thermal Relief | The desk worker needs relief from feeling too warm at their workplace so that they can keep working comfortably. | Critical | Desk Worker |
| Comfort Without Attention | The desk worker needs the relief to remain effective as they move and change posture at their desk so that they do not have to interrupt their work to maintain it. | High | Desk Worker |
| Simple Use And Control | The desk worker needs the system to be easy to start and adjust so that they can obtain their preferred level of relief without distracting from their work. | Medium | Desk Worker |
| Undisturbed Shared Workspace | The office neighbor needs the system not to disturb their working conditions so that another person’s comfort does not reduce their own. | High | Office Neighbor |
| Privacy Of People Nearby | People near the system need it not to expose information about them or their workplace so that they can work without feeling observed. | High | Desk Worker, Office Neighbor |
| Safe Nearby Use | People near the system need it to operate without causing harm during normal prolonged use. | Critical | Desk Worker, Office Neighbor |
| Fits Ordinary Workplaces | The product manager needs the system to be usable at ordinary desks and workplaces without preparation or modification so that it serves the intended market. | High | Product Manager |
Anforderungen mit Syside visualisieren
Um die obige Tabelle der Anforderungen zu erzeugen, habe ich geschummelt: Ich habe sie mit einem kleinen Python-Skript erzeugt (ebenfalls in gitHub). Natürlich lassen diese sich auch von den meisten Werkzeugen anzeigen lassen. allerdings ist der Default dabei ein Diagramm, keine Tabelle. Hier die Visualisierung mit Syside:

Es ist offensichtlich, dass diese Sicht weder skaliert, noch den selben Grad an Nutzen hat wie die Tabellenansicht.
Glücklicherweise hat SysML v2 die Möglichkeit, Views zu erzeugen. Experimente damit waren allerdings frustrierend: Zum Beispiel ist es nicht, oder nur sehr schwer möglich, die Stakeholder wie oben in den View mit aufzunehmen. Doch selbst wenn das gelingen sollte: Dann steckt der View im gewählten Werkzeug. Das erzeugt Reibung, die wiederum den Flow von Design in Progress (DIP) bremst.
Daher meine praktische Empfehlung: Findet heraus, welche Stakeholder wann welche Informationen benötigen. Dann findet den besten Weg, dies sicherzustellen. Das kann bedeuteten, die Daten on demand per SysML v2 API aus der Datenbank zu ziehen und in anderen Systemen (read-only) zu spiegeln. Oder es kann ein einfaches Skript sein, was sich für ein simples Lehrprojekt wie diesem anbietet.
Ausblick auf die nächsten Teile
Ich werde in den nächsten Wochen an diesem Projekt weiterarbeiten und Ergebnisse veröffentlichen, wenn sie spruchreif sind. Dabei werde ich mich an den Entwicklungsprozess halten. Voraussichtlich kommen bald:
- System Context and Use Cases: Systemgrenze, Akteure und relevante Interaktionen modellieren.
- System Requirements: Verifizierbare Systemanforderungen aus den Stakeholder Needs ableiten und rückverfolgbar machen.
- System Architecture: Verhalten und Struktur entwickeln, die diese Anforderungen erfüllen.
- Verification and Validation: Nachweise ergänzen, dass Anforderungen erfüllt und Stakeholder Needs adressiert werden.
Der Fokus soll dabei immer auf dem Nutzen für die Stakeholder liegen. Das Modell ist kein Selbstzweck. Es sollte nur so viel Modellierung entstehen, wie nötig ist, um bessere Entscheidungen zu treffen, Zusammenhänge sichtbar zu machen und Stakeholder Value zu unterstützen.


