
Anti-Patterns im Systems Engineering: Wenn alles grün ist
Bei einem Automobilzulieferer entwickelt die Konstruktion einen Fensterheber. Für den Musterbau exportiert sie Daten in einem eher exotischen Format. Der Musterbau konvertiert die Dateien umständlich zurück, weil er das Format gar nicht benötigt. Beide Abteilungen glauben, die jeweils andere habe gute Gründe für dieses Vorgehen. Bis jemand nachfragt und feststellt, dass beide dasselbe native Format verwenden.
Dieses Beispiel erzählte Marc Löffler in unserem Webinar über Anti-Patterns in der Produktentwicklung. Das Beispiel zweigt, was wir oft im Systems Engineering erleben: Technisch kompetente Menschen arbeiten an einem gemeinsamen Produkt, doch an der Schnittstelle entsteht Aufwand ohne Nutzen. Alles funktioniert irgendwie, nur eben schlechter als nötig.
Marc Löffler ist Author, Keynote Speaker, Berater und der Urheber des Watermelon Pattern. Die Inhalte dieses Artikels stammen aus einem Gespräch, das Marc und ich im Rahmen eines Webinars geführt hatten. Die Vortragsfolien und weitere Resourcen sind hier zu finden.
Ein Anti-Pattern ist mehr als ein schlechter Prozess
Ein Anti-Pattern ist ein wiederkehrendes Vorgehen, das im Gesamtsystem unerwünschte Folgen erzeugt. Es kann sogar aus einer ursprünglich guten Lösung entstehen. Die Rahmenbedingungen ändern sich, der Prozess bleibt.
Im Gespräch ging es deshalb weniger um die Suche nach Schuldigen als um die Frage, warum solche Muster überleben. Beim Fensterheber ist der unnötige Dateiaustausch nur das sichtbare Symptom. Dahinter steht ein Kommunikationsproblem: Die Beteiligten haben ihre Annahmen über die Bedürfnisse der anderen Abteilung nie überprüft.
In einer komplexen Entwicklung betreffen solche Annahmen oft Schnittstellen, Freigaben, Teststrategien und Systemarchitekturen. Eine lokal vernünftige Regel kann über mehrere Disziplinen hinweg erhebliche Wartezeit erzeugen.
Das komplette Gespräch mit Marc Löffler ist hier eingebettet. Marc arbeitet als Berater, Autor und Speaker unter anderem zu Führung, Retrospektiven und Zusammenarbeit in technischen Organisationen.
Das Watermelon Pattern: Grün bis zum bösen Erwachen
Marc hat den Begriff Watermelon Pattern geprägt. Gemeint ist ein Projekt, das nach außen grün aussieht, innen aber längst rot ist. Auf Teamebene sind die Schwierigkeiten bekannt. Die nächste Führungsebene meldet vorsichtshalber Gelb. Weiter oben wird daraus Gelbgrün und schließlich ein grüner Gesamtstatus.
Die Gründe sind nachvollziehbar. Niemand möchte unnötige Aufmerksamkeit auslösen. Teams hoffen, den Rückstand selbst aufzuholen. Führungskräfte haben womöglich gelernt, dass schlechte Nachrichten Ärger bedeuten. Und manchmal möchte auch das Management nicht genau hinsehen, weil eine rote Ampel Handeln verlangt.
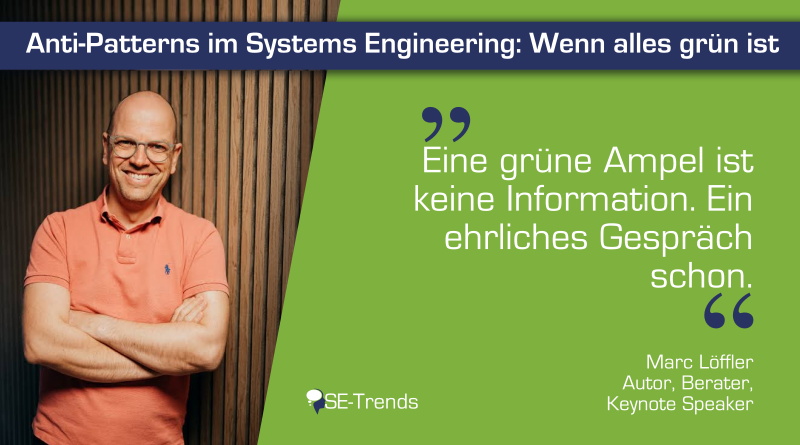
„Eine grüne Ampel ist keine Information. Ein ehrliches Gespräch schon.“
Marc Löffler
Im Systems Engineering ist das besonders problematisch. Ein grüner Status jeweils in den Domänen Mechanik, Elektronik und Software ergeben noch keinen grünen Systemstatus. Die kritischen Risiken stecken in den Wechselwirkungen. Wenn die Integration erst spät stattfindet, erfahren die Beteiligten unter Umständen erst dann, dass sich ihre Annahmen widersprechen.
Das Problem lässt sich in der Regel nicht durch weiteres Reporting lösen. Es braucht die Möglichkeit, Probleme früh zu benennen, und jemanden, der auf diese Information reagiert. Marc stellte dabei immer wieder den Zusammenhang zur psychologischen Sicherheit her. Wer für schlechte Nachrichten bestraft wird, fängt an, sie zu vertuschen.
Systemfortschritt ist mehr als erledigte Arbeitspakete
Welche Kennzahl belegt, dass ein System tatsächlich weiterentwickelt wurde? Im Webinar kam diese Frage von den Zuschauern. Sie ist für Systems Engineers extrem relevant, weil ein Projektplan häufig den Fortschritt der einzelnen Disziplinen abbildet, während die Funktionsfähigkeit des Gesamtsystems noch gar nicht überprüft wurde.
Marc schlug vor, reale Ergebnisse statt Berichte zu zeigen. Ein funktionierender Algorithmus lässt sich demonstrieren. Bei einem physischen Produkt helfen frühe Prototypen oder die Integration neuer Komponenten in einen vorhandenen Systemstand. Auch das ist zunächst nur eine Teilantwort: Ein Prototyp beweist weder die Produktreife noch die Einhaltung aller Anforderungen.
Gerade bei regulierten Produkten darf ein Demonstrator nicht mit einem verifizierten System verwechselt werden. Ein Gerät kann eine Funktion erfolgreich vorführen und trotzdem noch Monate an Dokumentation, Tests oder Zertifizierungsnachweisen benötigen. Im Gespräch wurde deshalb auch vor dem „umgekehrten Watermelon Pattern“ gewarnt: Das Management sieht etwas Funktionierendes und hält die Entwicklung voreilig für abgeschlossen.
Für das Projektmanagement folgt daraus eine Dilemma: Der Fortschritt muss auf mehreren Ebenen sichtbar sein: Welche Funktionen laufen im integrierten System? Welche Anforderungen wurden mit belastbaren Tests verifiziert? Welche Nachweise fehlen für eine Freigabe? Eine einzige Ampelfarbe kann diese Unterschiede nicht abbilden.
Traceability: Vollständige Links, unvollständiges Wissen
Ein anschaulicher Sonderfall ist Traceability. Ein Projekt kann melden, dass alle Anforderungen mit Testfällen verknüpft sind. Das ist eine klare und leicht messbare Zahl. Sie sagt allerdings noch nichts darüber aus, ob die Verknüpfungen korrekt sind, ob die Tests zum aktuellen Systemstand passen oder ob die relevanten Systemfunktionen tatsächlich verifiziert wurden.
Ich habe dieses Problem schon im Beitrag Warum ignorieren wir die Qualität der Traceability? beschrieben. Dort geht es unter anderem darum, dass sich Traceability bei Änderungen verschlechtert, wenn die Links nicht gepflegt werden. Der scheinbar vollständige Nachweis kann damit ein falsches Sicherheitsgefühl erzeugen.
Im Webinar wurde über einen Medizintechnik-Kontext gesprochen, in dem Traceability und Testfälle für die Prüfung automatisiert aufbereitet wurden. Dabei geht es vor allem darum, diese Nachweise während der Entwicklung aktuell zu halten. Werden Tests, Anforderungen und Implementierung während der Entwicklung miteinander verbunden, fällt die Prüfung nicht erst kurz vor der Zertifizierung vom Himmel.
Automatisierung allein löst das Problem allerdings nicht. Ein automatisch aktualisierter Link ist noch kein korrekter Link. Systems Engineering muss deshalb den Zusammenhang zwischen Artefakten und die Qualität der Nachweise prüfen. Genau dafür sind Reviews und technische Integration da.
Gute Metriken beginnen beim Problem
Marc formulierte eine provokante Faustregel:
„Wenn die Metrik leicht zu heben ist, ist es meistens keine gute Metrik.“
Marc Löffler
Das gilt nicht ausnahmslos. Aber es erklärt, warum Organisationen gern das zählen, was ihre Werkzeuge bereits liefern: abgeschlossene Tickets, geschriebene Anforderungen, Story Points oder erledigte Reviews. Diese Zahlen beschreiben Aktivität. Ob die Aktivität das Gesamtsystem vorangebracht hat, bleibt offen.
Für eine konkrete Entwicklungsorganisation wären andere Fragen aufschlussreicher:
- Lead Time: Wie viel Zeit vergeht zwischen einer neuen Kundenanforderung und einer überprüfbaren Änderung am Produkt?
- Integrationsverzug: Wie lange dauert es, bis eine geänderte Komponente im Gesamtsystem getestet wird?
- Rückfragen und Übergaben: Wie viele organisatorische Stationen durchläuft ein technisches Problem, bevor es entschieden werden kann?
- Parallele Arbeit: Wie viele Projekte oder Änderungen konkurrieren gleichzeitig um dieselben Spezialisten und Testeinrichtungen?
Keine dieser Kennzahlen ist automatisch gut. Man muss wissen, welches Problem damit untersucht werden soll. Ein Projekt, das unter später Integration leidet, gewinnt wenig durch die präzisere Zählung von Requirements. Und ein Team mit langen Entscheidungswegen wird nicht schneller, wenn es seine Tickets detaillierter kategorisiert.
Die Erhebung kann mühsam sein, weil Anfangs- und Endpunkte häufig in unterschiedlichen Systemen liegen. Gerade diese Lücke zwischen den Werkzeugen zeigt, wie wenig der gesamte Entwicklungsfluss bislang beobachtet wird.
Frühe Integration heißt auch frühe Zusammenarbeit
Marc berichtete von einem Projekt beim Medizintechnikunternehmen Erbe. Dort arbeiteten unter anderem Fertigungsplaner früh in den Entwicklungsteams mit. Mechanik und Software entwickelten sich gemeinsam bis zur nächsten großen Übergabe. Probleme für Fertigung oder Verpackung konnten bereits während der Entwicklung angesprochen werden.
Das ist ein praktisches Beispiel für ein Problem, das Systems Engineers seit Langem kennen. Fehler an disziplinübergreifenden Schnittstellen lassen sich nur schwer entdecken, solange jede Disziplin ihr eigenes Teilprodukt bewertet. Die organisatorische Schnittstelle ist deshalb genauso relevant wie die technische (Conway’s Law).
Dazu gehört auch die Compliance. Im Gespräch beschrieb Marc ein Projekt im Bankenumfeld, in dem ein Cybersecurity-Verantwortlicher parallel zur Umsetzung eingebunden war. Dadurch konnten regulatorische Fragen direkt geklärt werden, statt sie am Ende als zusätzliche Freigabestufe zu behandeln. Das kann die Wartezeit reduzieren.
Für Systems Engineers ergeben sich daraus konkrete Fragen an das Projekt: Wann sehen wir erstmals ein integriertes System? Wer prüft, ob die Schnittstellenannahmen zusammenpassen? Sind Fertigung, Verifikation und Zulassung früh genug beteiligt, um den Entwurf noch beeinflussen zu können?
Diagnose vor Gegenmaßnahme
Die gefährlichste Reaktion auf ein erkanntes Anti-Pattern ist eine pauschale Lösung. Wenn eine Freigabe zu lange dauert, kann man Unterschriften reduzieren. Vielleicht löst das ein Problem. Vielleicht verdeckt es aber nur, dass Verantwortlichkeiten ungeklärt sind oder niemand weiß, welche Risiken tatsächlich geprüft werden müssen.
Dasselbe Anti-Pattern kann unterschiedliche Ursachen haben. Eine verspätete Integration entsteht beispielsweise durch fehlende Testmöglichkeiten, inkompatible Schnittstellen oder durch Organisationsstrukturen, in denen niemand die Systemintegration verantwortet. Jede Ursache verlangt eine angepasste Maßnahme.
Marc empfahl regelmäßige Retrospektiven. Dabei geht es nicht darum, möglichst viele Verbesserungsmaßnahmen zu sammeln. Interessant sind Situationen, die sich wiederholen. Wenn eine Schnittstelle zum dritten Mal erst bei der Integration Probleme verursacht, lohnt die Frage, welche Annahme oder Arbeitsweise dahintersteht.
Besonders interessant fand ich Marcs Empfehlung, solche Retrospektiven in großen Projekten auch teamübergreifend durchzuführen, etwa alle drei Monate. Lokale Retrospektiven sind sinnvoll. Wenn das Problem zwischen Teams liegt, muss die Reflexion aber ebenfalls über die Teamgrenzen reichen.
Als Hilfsmittel gibt es den Product Velocity Anti-Pattern Finder. Er schlägt anhand einiger Fragen mögliche Muster vor. Das Ergebnis ist ein Ausgangspunkt für die Untersuchung, keine automatische Diagnose und erst recht kein fertiger Maßnahmenplan. Über den Ansatz hatte ich bereits in einem früheren SE-Trends-Beitrag geschrieben.
Fazit
Im Systems Engineering sind Anti-Patterns selten spektakulär. Ein überflüssiges Dateiformat, ein Freigabeprozess ohne erkennbare Begründung oder eine grüne Projektampel sind für sich genommen kleine Beobachtungen. Teuer werden sie, wenn sich derselbe Mechanismus über viele Schnittstellen fortsetzt und Probleme erst bei der Integration sichtbar werden.
Für die Praxis würde ich deshalb mit einer Frage beginnen: Welches Problem haben wir in den vergangenen Monaten mehrfach entdeckt, obwohl jede beteiligte Disziplin ihre Arbeit für abgeschlossen hielt? Die Antwort führt häufig zu einer Annahme, die nie zwischen den Disziplinen abgeglichen wurde.
Systems Engineering hat die Aufgabe, den Blick auf das Gesamtsystem zu richten. Dazu gehört, die Qualität der Nachweise zu hinterfragen, Systemfunktionen früh zu integrieren und den Fortschritt über Disziplingrenzen hinweg sichtbar zu machen. Wenn die Ampel dann rot wird, ist das eine Gelegenheit, rechtzeitig zu handeln.


